Showing posts with label Büyük Dil Modelleri. Show all posts

Saturday, September 26, 2026

Yapay Zekanın Yolculuğu

YAPAY ZEKÂ • LLM • AGENTIC AI • 2027

Yapay Zekâdaki Devrimi Yaşarken Fark Etmek: Deep Learning’den Uzun Süre Çalışan Agent’lara

Son 15 yılda yapay zekâ yalnızca daha başarılı modeller üretmedi. Görüntüyü tanıyan sistemlerden konuşan modellere, konuşan modellerden araç kullanan agent’lara, oradan da saatlerce hatta günlerce bir problem üzerinde çalışabilen yapay zekâ sistemlerine geçtik. Peki 2027’nin kırılma noktası ne olacak?

Bir sohbetten geriye kalan soru

Bugün yapay zekâya meraklı bir dostumla sohbet ederken konu doğal olarak son yıllarda bu alanda yaşanan baş döndürücü gelişmelere geldi.

Bir süre sonra geçmişte hangi teknolojileri konuştuğumuzu hatırlamaya başladık. Deep Learning, RNN, LSTM, Transformer, büyük dil modelleri, multimodal modeller, reasoning modeller, RAG, function calling, agent’lar, MCP, computer use, coding agent’ları ve son olarak uzun süre çalışabilen agent sistemleri...

Hepsini arka arkaya sıraladığımızda değişimin hızını daha net fark ediyorsunuz.

Aslında son birkaç yılda yalnızca daha başarılı yapay zekâ modelleri geliştirmedik. Yapay zekâyı kullanma biçimimiz de birkaç kez tamamen değişti.

Yapay zekâ, örüntüleri tanıyan bir sistemden bizimle konuşan bir sisteme, oradan düşünen, araç kullanan ve giderek kendi başına iş yapabilen bir sisteme dönüşüyor.

🧠 1. Deep Learning: Büyük kırılmanın başlangıcı

Yapay sinir ağları elbette yeni değildi. Ancak uzun yıllar boyunca yeterli veri, hesaplama gücü ve uygun eğitim tekniklerinin bulunmaması nedeniyle potansiyellerinin önemli bir kısmını gösterememişlerdi.

2012’de AlexNet’in ImageNet yarışmasında elde ettiği başarı, GPU üzerinde eğitilen çok katmanlı yapay sinir ağlarının ne kadar güçlü olabileceğini gösterdi.

Computer vision alanında başlayan bu sıçrama kısa sürede konuşma tanıma, doğal dil işleme ve diğer makine öğrenmesi problemlerine yayıldı.

Bugünden baktığımızda basit görünebilir ama bugün yaşadığımız yapay zekâ devriminin önemli başlangıç noktalarından biri burada oluştu:

Daha büyük ağlar + daha fazla veri + daha fazla hesaplama gücü.

🔁 2. RNN, LSTM ve Sequence-to-Sequence

Görüntülerde CNN mimarileri büyük başarı gösterirken doğal dil tarafında farklı bir sorun vardı. Dil sıralı bir yapıydı.

RNN ve özellikle LSTM gibi mimariler geçmişten gelen bilgiyi belirli ölçüde taşıyarak cümleler, konuşmalar ve zaman serileri üzerinde çalışmayı mümkün hale getirdi.

Ardından sequence-to-sequence, yani seq2seq mimarileri geldi. Bir diziyi alıp başka bir dizi üretmek mümkün hale geldi. Makine çevirisi bunun en önemli uygulamalarından biri oldu.

Bugün bir modele verdiğimiz metnin karşılığında yeni bir metin üretmesini çok doğal karşılıyoruz. Ancak bugünkü üretken modellerin geçmişindeki önemli basamaklardan biri encoder-decoder ve seq2seq çalışmalarıydı.

👁️ 3. Attention: Model nereye bakması gerektiğini öğreniyor

Burada kronolojik olarak önemli bir ayrıntı var. Attention mekanizması Transformer ile başlamadı.

2014 civarında özellikle neural machine translation çalışmalarında modelin kaynak cümlenin her bölümüne aynı şekilde yaklaşmak yerine, çıktı üretirken ilgili bölümlere daha fazla dikkat verebilmesi gösterildi.

Bu fikir son derece önemliydi. Çünkü model artık bütün girdiyi tek bir sabit temsil içerisine sıkıştırmak zorunda değildi.

⚡ 4. 2017: Attention Is All You Need

2017’de yayımlanan Attention Is All You Need makalesi yapay zekâ tarihinin en önemli dönüm noktalarından biri oldu.

Transformer mimarisi, RNN’lerdeki sıralı işleme bağımlılığını büyük ölçüde ortadan kaldırdı ve self-attention mekanizmasını merkeze aldı.

Self-attention sayesinde bir metindeki farklı kelimeler arasındaki ilişkiler doğrudan modellenebiliyor ve hesaplamalar çok daha verimli biçimde paralelleştirilebiliyordu.

Bugün kullandığımız GPT, Claude, Gemini, Llama, Qwen, Mistral ve benzeri büyük model ailelerinin mimari köklerinde büyük ölçüde bu dönüşüm bulunuyor.

📚 5. Pre-training ve Foundation Model yaklaşımı

Transformer’dan sonra başka bir paradigma güç kazandı.

Her görev için ayrı bir model eğitmek yerine, çok büyük veri kümeleri üzerinde genel amaçlı bir model eğitip daha sonra bunu farklı görevlere uyarlamak.

BERT gibi modeller bu yaklaşımın doğal dil işlemede ne kadar güçlü olabileceğini gösterdi.

Böylece tartışma yalnızca “hangi mimari daha başarılı?” sorusundan uzaklaşıp, çok sayıda görevi gerçekleştirebilecek genel amaçlı modeller geliştirmeye doğru kaydı.

📈 6. Scaling ve GPT-3

2020 civarında model büyüklüğü, eğitim verisi ve hesaplama gücünün artırılmasıyla performans arasındaki ilişki çok daha görünür hale geldi.

Scaling laws çalışmaları, daha büyük modellerin yalnızca aynı görevleri biraz daha iyi yapmadığını, bazı yeni yeteneklerin de model ölçeği arttıkça ortaya çıkabildiğini gösteriyordu.

GPT-3 ise başka bir önemli özelliği görünür hale getirdi:

Bir modele her görev için yeniden eğitim vermeden, yalnızca talimat ve birkaç örnek aracılığıyla çok farklı görevler yaptırılabiliyordu.

Zero-shot ve few-shot kullanım giderek daha önemli hale geldi.

📄 7. RAG: Modelin parametrelerinin dışına çıkmak

Büyük dil modellerinin önemli problemlerinden biri güncel, kuruma özel veya modelin eğitiminde bulunmayan bilgiye erişememeleriydi.

Retrieval-Augmented Generation, yani RAG yaklaşımı bu problemi farklı bir şekilde ele aldı.

Her bilgiyi modelin parametrelerine koymak yerine, soruyla ilgili bilgi dışarıdaki bir bilgi kaynağından bulunuyor ve modelin context’ine ekleniyordu.

Daha sonra embedding, vector database, semantic search, hybrid search, reranking, query rewriting ve knowledge base mimarileriyle RAG çok daha gelişmiş bir yapıya dönüştü.

Özellikle kurumsal yapay zekâ uygulamalarında bu yaklaşım bugün hâlâ son derece önemli.

🎨 8. Diffusion modelleri ve üretken görsel yapay zekâ

Bu sırada yapay zekâ devrimi yalnızca metin üzerinde ilerlemiyordu.

Diffusion modellerinin gelişmesiyle metinden görüntü üretmek çok hızlı biçimde yaygınlaştı.

Ardından görüntü düzenleme, stil değiştirme, görselden video üretme, metinden video üretme, ses sentezi ve müzik üretimi gibi alanlarda hızlı ilerlemeler yaşandı.

Generative AI kavramı artık yalnızca metin üreten modelleri ifade etmiyordu.

👀 9. Multimodal modeller

Bir sonraki önemli adım farklı veri türlerinin aynı model içerisinde bir araya gelmesi oldu.

Model artık yalnızca yazdığımız metni anlamıyordu.

📷 Fotoğrafları anlayabiliyor.
📊 Grafikleri yorumlayabiliyor.
📑 Belgeleri okuyabiliyor.
🎙️ Sesi anlayabiliyor.
🖥️ Bilgisayar ekranını görebiliyor.
🎥 Videoları analiz edebiliyor.

Gerçek dünya yalnızca metinden oluşmadığı için multimodalite yapay zekânın genel amaçlı hale gelmesi açısından çok önemli bir adımdı.

💬 10. 2022: ChatGPT ile yapay zekâ geniş kitlelerle buluştu

30 Kasım 2022’de ChatGPT’nin kullanıma açılması bence teknolojik olduğu kadar toplumsal bir kırılma noktasıydı.

Büyük dil modelleri ilk kez bu ölçekte sıradan kullanıcıların günlük hayatına girdi.

Öğretmenler, öğrenciler, doktorlar, avukatlar, mühendisler, yöneticiler, sanatçılar ve yazılımcılar aynı teknolojiyle konuşmaya başladı.

Instruction tuning ve insan geri bildirimiyle hizalama gibi çalışmalar sayesinde kullanıcı açısından çok daha doğal bir etkileşim ortaya çıktı.

Aynı dönemde yeni bir kavram da günlük dilimize girdi:

Prompt Engineering.

🔧 11. Function Calling ve Tool Use

Büyük dil modelleri çok etkileyici metinler üretebiliyordu. Ancak gerçek dünyadaki sistemlerle etkileşimleri sınırlıydı.

Function calling ve tool use yaklaşımı bunu değiştirmeye başladı.

Model artık bir API çağırabiliyor, veritabanına erişebiliyor, hesaplama aracı kullanabiliyor, arama yapabiliyor veya başka bir yazılım bileşenini çalıştırabiliyordu.

Eski yaklaşım: “Soruyu cevapla.”
Yeni yaklaşım: “Problemi çözmek için gerekiyorsa araç kullan.”

Bu küçük görünen değişim daha sonra agent sistemlerinin temelini oluşturdu.

🧠 12. Reasoning modeller

2024’te reasoning modellerin yaygınlaşmasıyla başka bir paradigma daha ortaya çıktı.

Artık yalnızca modele daha fazla parametre eklemekten değil, modelin cevap vermeden önce problem üzerinde daha fazla hesaplama yapmasından söz ediyorduk.

Test-time compute kavramı önem kazandı.

Özellikle matematik, bilim, kodlama ve karmaşık problem çözme alanlarında “daha büyük model” yaklaşımının yanına “problem üzerinde daha uzun çalışan model” yaklaşımı eklendi.

💻 13. Chatbot’tan Coding Agent’a

Bence yakın dönemin en önemli dönüşümlerinden biri yazılım geliştirme alanında gerçekleşti.

İlk aşamada modellerden kod parçaları istemeye başladık.

Sonra IDE içerisine yerleşen copilot sistemleri geldi.

Daha sonra yapay zekâ bütün repository’yi okumaya, dosya oluşturmaya, terminal çalıştırmaya, hata ayıklamaya, test yazmaya ve kodu yeniden düzenlemeye başladı.

💬 Kod hakkında konuşan sistem
➡️ Kod öneren sistem
➡️ Kod yazan sistem
➡️ Repository üzerinde çalışan sistem
➡️ Yazılım geliştirme görevini üstlenen agent

🔌 14. MCP: Yapay zekâ ile dış dünya arasında standart bağlantılar

Agent sistemleri yaygınlaştıkça başka bir problem ortaya çıktı.

Her yapay zekâ uygulamasını GitHub, dosya sistemi, veritabanı, kurumsal yazılımlar ve farklı servislerle ayrı ayrı entegre etmek gerekiyordu.

Model Context Protocol, yani MCP, yapay zekâ uygulamaları ile araçlar ve veri kaynakları arasında daha standart bağlantılar kurulabilmesi açısından önemli bir gelişme oldu.

Bence MCP’yi yalnızca teknik bir protokol olarak görmemek gerekiyor. Agent ekosisteminin büyümesi için modellerin dış dünyaya standart ve yönetilebilir biçimde bağlanması çok önemli.

🧩 15. Agent Skills

Sonraki aşamada agent’lara belirli işleri nasıl yapacaklarını tekrar tekrar açıklamak yerine yeniden kullanılabilir beceriler tanımlama yaklaşımı güç kazandı.

Bir skill örneğin:

📊 Bir Excel dosyasının nasıl analiz edileceğini,

📄 Profesyonel bir raporun nasıl hazırlanacağını,

🧪 Bir test sürecinin nasıl yürütüleceğini,

🏢 Kuruma özel bir prosedürün nasıl uygulanacağını,

💻 Belirli bir yazılım geliştirme işinin nasıl yapılacağını

agent’a gerektiği anda öğretebiliyor.

Bu yaklaşım genel amaçlı yapay zekâdan uzmanlaşmış dijital çalışanlara geçiş açısından oldukça önemli görünüyor.

🖥️ 16. Computer Use ve Browser Use

Daha sonra agent’lar yalnızca API kullanmakla kalmadı.

Ekranı görmeye, fareyi hareket ettirmeye, butonlara basmaya, web sayfalarında gezinmeye ve bizim kullandığımız grafik kullanıcı arayüzlerini kullanmaya başladı.

Bu bence çok kritik bir gelişme.

Çünkü dünyadaki yazılımların büyük kısmının yapay zekâ için hazırlanmış API’leri yok. Ancak neredeyse hepsinin insanlar için geliştirilmiş bir kullanıcı arayüzü var.

Computer use ile birlikte kullanıcı arayüzünün kendisi bir anlamda yapay zekânın kullanabileceği yeni bir entegrasyon katmanına dönüşüyor.

🌍 17. Açık modeller ve lokal yapay zekâ

Bütün bu gelişmeler devam ederken paralel bir dönüşüm daha yaşandı.

Açık ağırlıklı modeller, kapalı modellerle aralarındaki farkı birçok kullanım alanında hızla azalttı.

Llama, Mistral, Qwen, DeepSeek ve benzeri model aileleri güçlü bir açık ekosistem oluşturdu.

Quantization, daha verimli inference motorları ve donanım gelişmeleri sayesinde daha önce yalnızca büyük veri merkezlerinde çalıştırılabilecek modeller kişisel bilgisayarlarda ve kurum içi sunucularda çalışmaya başladı.

Yapay zekâ artık yalnızca internet üzerinden eriştiğimiz bir bulut servisi olmak zorunda değil.

Verinin kurum dışına çıkmadan işlendiği lokal yapay zekâ sistemleri giderek daha gerçekçi bir seçenek haline geliyor.

Kişisel bilgisayarda sürekli çalışan agent yazılımlarının ortaya çıkması da bu dönüşümün önemli parçalarından biri.

🤖 18. 2026: Agent yılı

2026 için uzun zamandır “agent’ların yılı olacak” deniyordu.

Bence bu tahmin önemli ölçüde gerçekleşti.

Ancak agent kavramının kendisi de değişti.

İlk agent mimarilerinde yapı kabaca şöyleydi:

LLM → araç çağır → sonucu gör → gerekirse başka araç çağır → cevap ver

Bugün ise çok daha kapsamlı sistemlerden söz ediyoruz.

🧭 Planlama yapıyor.

🧰 Doğru aracı seçiyor.

🗂️ Dosyaları ve context’i yönetiyor.

🧠 Durum bilgisini koruyor.

🤝 Başka agent’lara görev verebiliyor.

💻 Kod ve terminal çalıştırabiliyor.

🌐 Web üzerinde işlem yapabiliyor.

🔍 Kendi ürettiği sonucu kontrol edebiliyor.

🛡️ Yetki sınırlarını dikkate alabiliyor.

👤 Gerektiğinde insan onayı isteyebiliyor.

🏗️ 19. Sonraki aşama: Agent Harness

Son dönemde benim özellikle önemli bulduğum kavramlardan biri agent harness.

Çünkü agent’lara daha karmaşık ve uzun görevler vermeye başladığımızda yalnızca modelin ne kadar akıllı olduğu yeterli olmuyor.

Bir model ilk birkaç adımı çok başarılı tamamladıktan sonra yanlış bir yöne gidebilir.

Görevin bittiğini erken düşünebilir.

Önceki kararlarını unutabilir.

Test etmeden sonuca ulaşabilir.

Uzun süreli görevlerde context giderek bozulabilir.

Bu nedenle modelin etrafında onu yöneten bir çalışma ortamına ihtiyaç duyuluyor.

📝 Planı korur.
🔄 Gerektiğinde yeniden planlama yaptırır.
🧪 Sonuçları test eder.
🔍 Eksikleri tekrar kontrol ettirir.
📚 Context yönetimini gerçekleştirir.
📈 Çalışmanın ilerlemesini izler.
✅ Sonucu bağımsız olarak doğrulatabilir.
🛑 Agent’ın ne zaman duracağına karar verilmesine yardımcı olur.

Böylece birkaç dakika boyunca çalışan chatbot yerine saatlerce hatta uygun altyapılarda çok daha uzun süre bir hedef üzerinde çalışabilen sistemlere doğru ilerliyoruz.

BENCE ASIL KIRILMA BURADA
Yarış artık yalnızca “en iyi LLM kimde?” yarışı değil.
Yarış; modeli doğru veri, doğru araçlar, doğru bellek, doğru beceriler, doğru güvenlik mekanizmaları ve doğru doğrulama sistemi içerisinde ne kadar başarılı çalıştırabildiğinizle ilgili.

Yapay zekânın kısa tarihi aslında nasıl değişti?

🧠 2010’lar → Model örüntüleri tanıyor.
💬 2022 → Model bizimle konuşuyor.
👀 2023–2024 → Model görüyor ve duyuyor.
🧠 2024 → Model problem üzerinde daha uzun düşünüyor.
🔧 2023–2025 → Model araç kullanıyor.
🖥️ 2024–2025 → Model bilgisayar ve tarayıcı kullanıyor.
🤖 2025–2026 → Model agent’a dönüşüyor.
🏗️ 2026 → Agent uzun süre çalışabileceği bir sistem içerisine yerleşiyor.

🔮 Peki 2027 neyin yılı olacak?

Bence bir sonraki büyük sıçrama yalnızca yeni ve daha güçlü bir sohbet modeli olmayabilir.

Benim güçlü adaylarımdan biri persistent agent, yani uzun süre çalışan, durumunu ve bağlamını koruyabilen kişisel ve kurumsal yapay zekâ sistemleri.

Bugünkü chatbot yaklaşımında biz yapay zekâya gideriz.

Bir pencere açarız, sorumuzu sorarız ve cevabı aldıktan sonra çalışmaya devam ederiz.

Bir sonraki aşamada ise yapay zekâ çalışma ortamımızın sürekli bir parçası olabilir.

🧠 Geçmiş çalışmalarımızı gerektiğinde hatırlayabilir.

📧 E-posta ve mesajlarla çalışabilir.

📅 Takvim ve görevleri takip edebilir.

📁 Dosya ve projeleri anlayabilir.

🌐 Gerektiğinde araştırma yapabilir.

💻 Bilgisayarda işlem gerçekleştirebilir.

🧩 İhtiyacı olan becerileri kullanabilir.

🔌 Kurumsal sistemlere bağlanabilir.

🤝 Başka uzman agent’larla çalışabilir.

🛡️ Yetki sınırlarını dikkate alabilir.

👤 Kritik işlemlerde insan onayı isteyebilir.

✅ Kendi yaptığı işi doğrulayabilir.

☁️ Bulut mu, lokal mi?

Bunun tamamen bulutta çalışan bir yapı olacağını da düşünmüyorum.

Kişisel ve kurumsal verinin önemi arttıkça hibrit mimarilerin daha anlamlı hale gelmesi muhtemel.

Küçük ve hızlı modeller lokal olarak sürekli çalışabilir.

Daha karmaşık reasoning gerektiğinde güçlü bulut modellerinden destek alınabilir.

Kuruma özel bilgi kurum içerisinde tutulabilir.

Son derece hassas görevler tamamen lokal modellerle yürütülebilir.

Gelecekte “hangi modeli kullanıyorsunuz?” sorusu yerine “yapay zekâ sisteminiz nasıl bir mimari üzerinde çalışıyor?” sorusunu daha fazla sorabiliriz.

🤖 Bir başka güçlü aday: Physical AI

Bir başka önemli gelişme alanı ise yapay zekânın bilgisayar ekranından fiziksel dünyaya çıkması.

Vision, reasoning, planning ve agent teknolojileri robotik sistemlerle birleştiğinde embodied AI veya physical AI alanında büyük gelişmeler görebiliriz.

Bugün bilgisayar ekranındaki bir butona basmayı öğrenen agent’ın yarın fiziksel dünyadaki bir robotu yönlendirmesi aslında birbirinden tamamen bağımsız iki problem değil.

🚀 Belki de devrimin en önemli kısmı daha yeni başlıyor

Son 15 yıldaki gelişime baktığımda benim için en ilginç değişim sorularımızın değişmesi.

Deep Learning döneminde:

“Makine bunu tanıyabilir mi?”

diye soruyorduk.

LLM döneminde:

“Makine bunu anlayıp anlatabilir mi?”

sorusuna geçtik.

Reasoning modellerle:

“Makine bu problemi çözebilir mi?”

diye sormaya başladık.

Agent döneminde ise soru çok daha farklı:

“Bu işi baştan sona yapay zekâya verebilir miyim?”

Bence bu küçük bir değişim değil.

Bilgisayar tarihinin büyük bölümünde insanlar bilgisayarları kullanmayı öğrendi.

Şimdi bilgisayarlar bizim kullandığımız araçları kullanmayı öğrenmeye başlıyor.

Belki de önümüzdeki dönemin asıl dönüşümü burada yaşanacak.

🤔 Sizin tahmininiz nedir?

2027’de yapay zekâda hangi teknoloji veya yaklaşımın öne çıkacağını düşünüyorsunuz?

🤖 Kişisel ve sürekli çalışan AI agent’lar mı?

🏢 Kurumsal agent sistemleri mi?

🏗️ Agent harness ve uzun süreli otonom çalışma mı?

🧠 Daha güçlü reasoning modeller mi?

🖥️ Computer use ve browser use mı?

🌍 Açık ve lokal çalışan modeller mi?

🤖 Physical AI ve robotik mi?

Yoksa bugün henüz yeterince konuşmadığımız tamamen farklı bir kırılma mı geliyor?

Seçilmiş kilometre taşları

Krizhevsky, Sutskever & Hinton — ImageNet Classification with Deep Convolutional Neural Networks, 2012

Sutskever, Vinyals & Le — Sequence to Sequence Learning with Neural Networks, 2014

Bahdanau, Cho & Bengio — Neural Machine Translation by Jointly Learning to Align and Translate, 2014

Vaswani et al. — Attention Is All You Need, 2017

Devlin et al. — BERT, 2018

Kaplan et al. — Scaling Laws for Neural Language Models, 2020

Brown et al. — Language Models are Few-Shot Learners, 2020

Lewis et al. — Retrieval-Augmented Generation, 2020

Ho, Jain & Abbeel — Denoising Diffusion Probabilistic Models, 2020

#YapayZeka   #ArtificialIntelligence   #GenerativeAI   #LLM   #AIAgents   #AgenticAI   #DeepLearning   #Transformer   #ReasoningModels   #RAG   #MCP   #AgentSkills   #ComputerUse   #OpenSourceAI   #LocalAI   #AIEngineering   #FutureOfAI

Friday, March 6, 2026

Ollama Cloud ile Açık Kaynak Büyük Dil Modellerini (LLM) Bulutta Kullanmak

Ollama Cloud ile Açık Kaynak LLM'leri İndirmeden Denemek

Açık Kaynak büyük dil modelleri (LLM) dünyasında her gün yeni bir model ve yeni bir sürüm konuşuluyor. Bu çok iyi bir haber, çünkü artık "tek bir model"e mahkum değiliz. Ama pratikte çoğu kişi aynı iki probleme takılıyor: (1) Büyük modeller yerel GPU VRAM'ine sığmıyor, (2) Birden fazla modeli denemek için her seferinde devasa dosyalar indirmek, kurmak, silmek hem zaman hem de disk alanı tüketiyor. Kısacası, öğrenme ve deneme süreci daha en başta yorucu hale gelebiliyor.

Ben bu eğitimi tam da bu yüzden hazırladım: Açık Kaynak LLM'leri Bilgisayarınıza model dosyalarını indirip biriktirmeden de test edebilin. Üstelik sadece "çalıştırma" değil, doğru model seçimi ve uygulamaya entegrasyon mantığını da anlayın. Bu yazı, YouTube'daki eğitimimin blog formatında, ders notu kadar derinlemesine hazırlanmış versiyonu. Adım adım giderken, neden-sonuç ilişkisini de kurmaya çalışacağım.

Eğitim videosu (YouTube canlı yayın kaydı): https://youtube.com/live/QEZ8oF4A68k

Kodlar ve dokümanlar (GitHub deposu): https://github.com/kmkarakaya/OllamaCloud

Not: Bu yazıda mümkün oldukça Türkçe terimler kullanıyorum. Örneğin "Açık Kaynak" (open source), "bulut", "belirteç" (token), "akış" (stream) gibi. Kod ve komutlarda ise resmi isimler ve parametreler aynen kalıyor.

Bu Ders Notunu Nasıl Kullanmalısın?

Bu yazı iki tip okuyucu için tasarlandı:

  • LLM dünyasına yeni girenler: "Ben nereden başlayacağım, hangi kavramlar önemli?" diyenler.
  • Uygulama geliştirmek isteyenler: "Ben Python ile bir şey kurmak istiyorum, model denemeyi hızlı hale getirmek istiyorum." diyenler.

Benim önerim şu: Önce kavramları ve karar mantığını oku. Sonra CLI ile bir modeli çalıştır. Ardından API ve Python bölümüne geç. En sonda repodaki iki örneği (model karşılaştırma betiği ve Streamlit demo) çalıştırıp sonuçları yorumla. Bu sırayla ilerlersen, "ne yaptığını bilerek" ilerlemiş olursun.

Temel Kavramlar: Modeller Neden Ağır? (VRAM, RAM, Disk, belirteç)

Bir modelin "büyük" veya "ağır" olması tek bir şeye bağlı değil. Yeni başlayanların kafasını en çok karıştıran nokta da bu. Ben burada üç kaynak üzerinden anlatıyorum: Disk, RAM ve VRAM.

  • Disk: Model dosyalarını indirip sakladığın yer. Birkaç model denemek bile onlarca GB yapabilir.
  • RAM: CPU belleği. Bazı durumlarda (özellikle CPU ile çalışan senaryolarda) RAM sınırlayıcı olur.
  • VRAM: GPU belleği. Büyük modellerin yerelde hızlı çalışmasında çoğu zaman asıl sınırlayıcı kaynak budur.

Parametre sayısı arttıkça (örneğin 20B, 120B gibi) modelin kapasitesi artabilir, ama kaynak ihtiyacı da artar. Ancak tek mesele parametre sayısı değildir. Model çalışırken "KV cache" (kısaca bağlam belleği) de büyür. Bu cache, konuşma uzadıkça ve context window büyüdükçe artar. Bu yüzden "kısa bir soru" ile "uzun bir sohbet" aynı modelde farklı kaynak tüketimi üretebilir.

Bir diğer kritik kavram: belirteç. Modelin okuduğu ve ürettiği metin parçaları belirteçlere bölünür. Bir prompt ne kadar uzunsa, o kadar fazla belirteç işlenir. Bir konuşma geçmişi ne kadar uzunsa, modelin "tek seferde düşünmesi" için o kadar fazla belirteç taşınır. Bu hem süreyi (gecikme) hem de bellek ihtiyacını etkiler. Bu yüzden iyi bir pratik: Modeli değerlendirirken sadece tek bir prompt değil, farklı uzunluklarda promptlar denemek.

Peki quantization (kuantizasyon) ne işe yarar? Çok basit anlatayım: Modeli daha düşük hassasiyetle temsil ederek daha az bellek kullanmasını sağlar. Bu sayede bazı modeller yerelde çalışabilir hale gelir. Ama bazen kalite ve tutarlılık üzerinde etkisi olabilir. Bu nedenle model seçimi yaparken "en büyük model en iyisidir" gibi basit bir kural yok. Senin senaryon için "yeterince iyi + yeterince hızlı + yönetilebilir maliyet" dengesi önemlidir.

Bu noktada Ollama Cloud'un değeri ortaya çıkıyor: İndirme ve donanım bariyerini azaltıp, senin hızlıca öğrenme ve deneme yapmanı sağlıyor. Yani önce doğru modeli seçiyorsun, sonra yerel veya bulut stratejini buna göre planlıyorsun.

KV Cache ve Context Window: Uzun Sohbet Neden Yavaşlar?

Yeni başlayanların en sık yaşadığı sürprizlerden biri şudur: Aynı model, kısa bir promptta çok hızlı cevap verirken; konuşma uzadıkça veya tek prompt çok uzayınca bariz şekilde yavaşlar. Bunun temel nedeni "modelin geçmişi nasıl taşıdığı" ile ilgilidir. Dil modelleri, her yeni belirteç üretirken önceki belirteçlere dikkat (attention) mekanizmasıyla bakar. Konuşma uzadıkça bakması gereken içerik artar; bu da hesaplama maliyetini ve bellek ihtiyacını yükseltir.

Bu işin bellek tarafındaki adı çoğu yerde KV cache olarak geçer. Çok basit anlatımla: Model, önceki belirteçlere ait bazı ara temsil bilgilerini (key/value) cache'ler ve sonraki adımlarda bunları kullanır. Context window büyüdükçe bu cache de büyür. Yerelde GPU kullanıyorsan bu cache çoğu zaman VRAM'de tutulur ve VRAM'in sınırlıysa uzun konuşmalarda daha çabuk sınıra dayanırsın. bulut'da bu sınır sende görünmez ama performans etkisini yine hissedebilirsin.

Bu yüzden ben model denemesinde şunu özellikle öneriyorum: Sadece "tek cümlelik bir soru" ile karar verme. Aynı modelde kısa prompt, orta prompt ve uzun prompt dene. Bir de "konuşma geçmişi" senaryosu dene. Çünkü gerçek uygulamada çoğu zaman kullanıcı bir soru sorup çıkmıyor; takip sorusu soruyor, detay istiyor, format değiştiriyor. Modelin bu akıştaki davranışı, tek seferlik cevap kadar önemlidir.

Pratik bir performans ipucu: Uygulamada konuşma geçmişini sınırsız büyütme. Gerekirse eski mesajları özetle, kritik noktaları "memory" gibi tek bir mesajda taşı. RAG (retrieval-augmented generation) gibi teknikler de burada devreye girer: Her şeyi konuşma geçmişinde tutmak yerine, ilgili bilgiyi dışarıdan çekip prompta eklersin. Bu hem maliyeti hem de gecikmeyi yönetmeyi kolaylaştırır.

Ollama Cloud Nedir? (CLI ve API İki Yol)

Ollama Cloud, desteklenen modelleri bulut üzerinden çalıştırıp denemeni sağlayan bir altyapı. Senin tarafında iki "arayüz" var: Ollama CLI ve Ollama API. Benim ders notu yaklaşımımda bunlar iki farklı hedefe hizmet eder:

  • CLI yolu: Hızlı deneme ve hızlı kıyaslama. Prompt yaz, cevap al, model davranışını gör.
  • API yolu: Uygulama entegrasyonu. Python ile web app, bot, servis veya otomasyon kur.

Resmi dokümanlar (okurken açık dursun): https://docs.ollama.com/cloud, https://docs.ollama.com/api

Not: "Ücretsiz deneme" ve limitler dönemsel olarak değişebilir. En güncel bilgiyi resmi sayfalardan kontrol etmeni öneririm.

Ne Zaman bulut, Ne Zaman Yerel?

bulut ve yerel kullanım birbirinin alternatifi değil; çoğu zaman birbirini tamamlar. Ben pratikte şöyle karar veriyorum:

  • bulut-öncelikli: Model denemek, model seçmek, hızlı prototip yapmak, eğitim/demo üretmek.
  • Local-first: Offline çalışma, çok sık istek, veri politikası nedeniyle tamamen yerel zorunluluk.

Eğer amacın "hangi model işimi görür?" sorusunu cevaplamaksa bulut yaklaşımı büyük hız kazandırır. Modeli seçtikten sonra yerelde koşmak istiyorsan, o aşamada donanım yatırımı veya daha küçük/kuantize bir model seçimi mantıklı hale gelir. Yani benim için bulut çoğu zaman bir "hızlandırıcı katman".

Model Deneme ve Karşılaştırma İçin Basit Bir Rubrik

Model denemek demek, aynı soruyu üç modele sormak demek değildir. Gerçek bir karşılaştırma yapmak için küçük bir rubrik gerekir. Benim kullandığım basit rubrik şu başlıklardan oluşur:

  • Talimat takibi: "Şu formatta yaz" dediğimde uyuyor mu?
  • Tutarlılık: Aynı soruyu tekrar sorunca benzer kalite veriyor mu?
  • Yapı ve okunabilirlik: Cevap düzenli mi, maddeleme iyi mi?
  • Doğruluk: Bariz hatalar yapıyor mu, uydurma eğilimi var mı?
  • Hız: Aynı prompt için yanıt süresi kabul edilebilir mi?
  • Dil uyumu: Türkçe sorularda Türkçe kalitesi yeterli mi?

Bu rubriği kullanarak "model seçimi"ni hızlandırabilirsin. Örneğin eğitimde kullandığım yaklaşım: Aynı konuda 2-3 farklı prompt tipi hazırla, sonra her modeli bu prompt setiyle test et. Böylece tek bir cevaba göre karar vermezsin. Özellikle "format zorlayan" promptlar modelin talimat takibini çok net gösterir.

Bu rubriği repodaki compare_models.py ile otomatikleştirmeye başladık. betik mükemmel bir kıyaslama değil, ama doğru düşünme biçimini öğretir: Önce yapılandırılmış görevler, sonra gerçek çıktı incelemesi.

Prompt Tasarımı İpuçları: Modeli Doğru Sınamak

Bir modelin "iyi" veya "kötü" olduğuna karar vermek için önce doğru prompt yazmak gerekir. Çünkü LLM'ler, soruyu nasıl sorduğuna göre çok farklı davranabilir. Benim ders notu şeklinde önerdiğim basit yaklaşım: Promptu dört parçaya böl ve her parçayı net yaz.

  • Rol: Modelden nasıl davranmasını istiyorsun? (Örn: "Bir eğitmen gibi anlat.")
  • Hedef: Tam olarak ne istiyorsun? (Örn: "RAG'i 5 maddeyle açıkla.")
  • Kısıt: Uzunluk, dil, format, ton gibi sınırlar. (Örn: "Her madde 1 cümle olsun.")
  • Çıktı formatı: Madde madde mi, JSON mu, tablo mu? (Örn: "Başlık + maddeler.")

Karşılaştırma yaparken de aynı konsept geçerli: Aynı rubrikle ölçmek istiyorsan, modellerin hepsine aynı formatı zorlayan promptları ver. Örneğin Türkçe üreteceksen mutlaka Türkçe prompt seti hazırla. Kod yazdıracaksan "basit kod", "hata ayıklama", "refactor" gibi farklı kod görevleri ekle. Bu sayede tek bir promptta parlayan ama diğer görevlerde dağılan modelleri erken fark edersin.

Bir başka pratik ipucu: Deneme promptlarını "gerçek iş" promptlarından ayır. Deneme promptu daha kısa ve daha kontrollü olur; gerçek iş promptu ise daha karmaşık ve daha çok bağlam içerir. Bu yüzden karar verirken iki tür promptu da kullan. Deneme promptu ile ele, gerçek iş promptu ile doğrula.

Güvenlik ve İyi Pratikler: API Key ile Çalışmak

API key bir şifre gibi düşünülmeli. En sık yapılan hata, API key'i koda gömmek veya depo içinde paylaşmak. Benim önerim: API key'i bir ortam değişkeni olarak tanımla ve uygulamada oradan oku.

Resmi yetkilendirme dokümanı: https://docs.ollama.com/api/authentication

Windows PowerShell tarafında, geçerli oturum için örnek:

$env:OLLAMA_API_KEY = "your_api_key_here"

Bu şekilde key'i kaynak koduna yazmadan, hem CLI tarafında hem de Python tarafında kullanabilirsin. Eğitim içeriklerinde özellikle şunu vurguluyorum: Key yönetimi "küçük bir detay" değil; ileride üretim ortamına gittiğinde en kritik alışkanlıklardan biri olacak.

CLI ile Başlamak: İlk Deneme Akışı (Neden Bu Komutlar?)

Önce Ollama'nın Windows kurulumu gerekiyor. Resmi Windows kurulum sayfası: https://docs.ollama.com/windows

Kurulumdan sonra amaç şu: bulut tarafına giriş yap ve bir modeli terminalde çalıştır. Temel akış:

ollama --version
ollama signin
ollama run gpt-oss:120b-cloud

Burada ollama signin kritik. bulut erişimi gerektiren işlemlerde yerel CLI'nin kimlik doğrulamasını yapmış oluyorsun. Sonra ollama run ile modeli interaktif moda alıyorsun. Bu noktada önemli pratik: İlk denemelerde kısa promptlarla başla, sonra uzun promptlara geç. Çünkü uzun prompt, hem hız hem de bağlam yönetimi açısından modeli daha fazla zorlar.

Bir diğer önemli not: bulut model isimleri CLI tarafında bazen -cloud ekiyle gelir. API tarafında ise model adları farklı görünebilir. Bu yüzden ben API entegrasyonlarında "model adını hardcode etme" alışkanlığını bırakmanı öneriyorum. Bunun çözümü bir sonraki bölümde: /api/tags.

Direkt API Yolu: /api/tags ile Model Keşfi, /api/sohbet ile Cevap

Uygulama geliştireceksen API tarafı kritik. Ben burada iki endpointi "temel taş" gibi görüyorum:

  • /api/tags: Hangi modeller erişilebilir? Bu sorunun cevabı.
  • /api/sohbet: Mesaj gönderip cevap almak.

Endpoint dokümanları: https://docs.ollama.com/api/tags, https://docs.ollama.com/api/chat

Benim pratik yaklaşımım: Model adını "varsayma". Önce /api/tags ile listeyi çek, sonra uygulamanda o listeden seçim yaptır. Bu sayede bir model erişilebilir değilse uygulama kırılmaz; sadece seçeneklerde görünmez.

Minimal bir curl örneği (PowerShell'de):

curl __URL_16__ `
  -H "Authorization: Bearer $env:OLLAMA_API_KEY"

sohbet tarafında stream parametresi önemli bir kavram. stream=false dersen tek seferde cevap alırsın. stream=true dersen cevap parça parça gelir. Web uygulamalarında akış kullanıcı deneyimini iyileştirir, ama kodu biraz daha dikkatli yazmayı gerektirir. Eğitimde ben önce stream=false ile mantığı kurup, sonra akışa geçmeni öneriyorum.

Python ile Entegrasyon: Mantığı Bir Kez Kur, Her Yerde Kullan

Python tarafında benim önerim şu: Önce en küçük "çalışıyor mu?" prototipini kur. Sonra aynı mantığı web uygulamasına taşı. Ollama Cloud Python dokümanı burada: https://docs.ollama.com/cloud#python

Kullandığımız Python paketi: https://github.com/ollama/ollama-python

Python tarafında temel fikir:

  • İstemciyi host="__URL_21__" ile bulut'a yönlendir
  • Header'a Authorization: Bearer ... koy
  • chat() çağrısında model ve mesajları gönder

Minimal örnek:

import os
from ollama import Client

client = Client(
    host="__URL_22__",
    headers={"Authorization": f"Bearer {os.environ['OLLAMA_API_KEY']}"},
)

resp = client.chat(
    model="gpt-oss:120b",
    messages=[{"role": "user", "content": "RAG nedir? 5 maddeyle anlat."}],
    stream=False,
)

print(resp["message"]["content"])

Burada mesaj formatı çok önemli. Mesajlar bir liste ve her mesajın role alanı var (örneğin user). Gerçek uygulamada konuşma geçmişi tutarsın: Önceki mesajları da yeni promptla birlikte gönderirsin. Bu sayede model bağlamı "hatırlar". Ama şu riski unutma: Konuşma geçmişi uzadıkça belirteç sayısı artar; bu da gecikmeyi artırabilir. Bu yüzden pratik bir yöntem: Geçmişi sınırlamak veya kritik noktaları özetleyip "memory" gibi göndermek.

Hata senaryolarını ders notu gibi düşünelim:

  • 401 Unauthorized: API key yanlış veya header formatı hatalı. İlk kontrol: ortam değişkeni + auth dokümanı.
  • 404 / model not found: Model adı erişilebilir değil; önce /api/tags ile listeyi kontrol et.
  • Timeout/slow: Çok büyük model veya yoğunluk; daha küçük modelle dene, istekleri azalt, akış kullan.

Bu üç hata tipi, pratikte en sık görülenler. Eğitimde de özellikle "önce tags, sonra sohbet" mantığını vurguluyorum.

depo Walkthrough: İki Bağımsız Örnekle Öğrenmeyi Hızlandırmak

Eğitimi izleyip "tamam anladım" demek kolay. Asıl değer, iki örneği çalıştırıp sonuçları yorumlamakta. depo içinde üç kritik dosya var: requirements.txt, compare_models.py, app.py. Bu üçü birlikte "deneme -> karşılaştırma -> demo" akışını tamamlıyor.

Önce bağımlılıkları kurmak ve örnekleri çalıştırmak için pratik komutlar:

pip install -r requirements.txt
python compare_models.py
streamlit run app.py

Şimdi iki örneği tek tek ders notu gibi inceleyelim.

compare_models.py ne yapıyor? Bu betik "model seçimi" problemine pratik bir yaklaşım getiriyor. İçindeki iki yapı çok önemli:

  • MODELS: Karşılaştırılacak model listesi (ör. gpt-oss:20b, gpt-oss:120b, qwen3-coder:480b)
  • TASKS: Modelin cevap vermesini istediğin yapılandırılmış görevler

Scriptin yaklaşımı şu: Her modele aynı görevleri sorar, yanıt süresini ölçer ve basit bir kalite skoru çıkarır. Bu skor bir hakem değil; bir "erken sinyal". Skorun mantığı dosyada açık:

  • Anahtar kelime kapsama skoru (0-60): Görev için kritik kelimeleri geçiriyor mu?
  • Format skoru (0-40): Maddeleme var mı, satır sayısı makul mü, yanıt uzunluğu yeterli mi?

Skorun amacı şu: Hızlıca "bu model talimatları takip ediyor mu?" sorusuna yaklaşmak. Ama karar verirken mutlaka raporu okuyacaksın. betik, tüm çıktıları model_comparison_report.md dosyasına yazar. Bu dosyayı açıp yanıtları yan yana okumak, gerçek kalite farkını görmenin en iyi yoludur.

Bu betiği kendi senaryona uyarlamak için pratik öneriler:

  • Kendi işine uygun 3-5 görev ekle (Türkçe özetleme, kod üretimi, e-posta yazma, hata ayıklama vb.).
  • MODELS listesini /api/tags ile gördüğün erişilebilir modellere göre güncelle.
  • Skorun "tek ölçüt" olmadığını unutma; raporu mutlaka oku.

Şimdi ikinci örnek: app.py. Bu dosya Streamlit ile basit bir web arayüzü kuruyor. Bu demo, özellikle öğrenme ve manuel test için çok değerli. Çünkü CLI'de hızlı denersin ama bazen promptları düzenlemek, farklı formatları denemek, çıktıyı kopyalayıp incelemek tarayıcıda daha rahattır.

Uygulamanın akışı:

  • API key'i ortamdan alır veya kullanıcıdan ister.
  • bulut'dan model listesini çeker ve seçim sunar.
  • Prompt gönderilir, cevap ekranda gösterilir.

Bu yapının asıl öğretici tarafı şudur: Modeli "hardcode" etmek yerine listeden seçtirmek. Böylece erişilebilir modeller değişse bile uygulama dayanıklı olur. Bu, üretim sistemlerinde de çok işe yarayan bir alışkanlıktır.

Uygulamayı geliştirmek istersen, başlangıç için birkaç fikir:

  • Konuşma geçmişi (sohbet geçmişi) ekle: Önceki mesajları saklayıp tekrar gönder.
  • akış yanıt ekle: Cevap yazılıyor gibi görünsün.
  • Prompt şablonları ekle: "özetle / maddele / kod yaz" gibi hazır butonlar.
  • Çıktıyı kaydet: Prompt ve cevapları logla, sonra analiz et.

Sık Yapılan Hatalar ve Pratik Çözümler

Bu bölüm gerçek hayatın özeti: Hata alırsın ve çözersin. Ben en sık şunları görüyorum:

  • 401 Unauthorized: API key yok, yanlış veya header formatı hatalı. Önce Authentication dokümanına bak, sonra ortam değişkenini kontrol et.
  • Model bulunamadı: Model adı erişilebilir değil. İlk adım: /api/tags ile modelleri listele ve doğru adı seç.
  • Çok yavaş yanıt: Büyük model veya yoğunluk olabilir. Daha küçük model dene, promptu kısalt, akış kullanmayı düşün.
  • Virtualenv karışıklığı: Farklı Python ortamına kurulum yapılıyor. En temiz yöntem: venv aç, sonra pip install -r requirements.txt.
  • Türkçe karakterler bozuk görünüyor: Kopyalama yaparken HTML editör modu dışında yapıştırmış olabilirsin. Blogger'da HTML görünümünde yapıştırmak genelde en sorunsuz yoldur.

Bu hataların ortak mesajı şu: Önce bağlantı ve yetkiyi doğrula, sonra model listesini doğrula, en son uygulama kodunu kurcala. Bu sırayla ilerlemek zamandan tasarruf ettirir.

Sık Sorulan Sorular (SSS)

Bu eğitimden sonra en çok gelen soruları kısa ve net cevaplayayım. Buradaki amaç "ezber" değil; doğru kontrol noktalarını öğretmek.

  • Ollama Cloud ücretsiz mi? Çoğu kişi bulutu "hızlı deneme" için kullanıyor. Ancak limit/politikalar zaman içinde değişebilir. En güncel bilgi için bulut sayfasını kontrol et.
  • Hangi modeller var, hangisini seçmeliyim? "Şu model kesin var" diye varsayma. Önce /api/tags ile listeyi gör. Seçimi rubrikle yap: talimat takibi, tutarlılık, hız, Türkçe kalitesi ve senin senaryona uygunluk.
  • CLI'de -bulut var ama API'de yok, neden? CLI ve API tarafında isimlendirme farklı görünebilir. Uygulama tarafında modeli listeden seçtirmen bu sorunu pratikte çözer.
  • ollama signin ile API key aynı şey mi? Hayır. ollama signin daha çok CLI akışı için oturum açma mantığıdır. API tarafında ise genelde API key + Bearer header ile çalışırsın. Detay için Authentication sayfasına bak.
  • Veri gizliliği açısından neye dikkat etmeliyim? Kural basit: Hassas veriyi göndermeden önce mutlaka politika/şartları oku ve kurumunun kurallarına göre hareket et. Eğitim ve demo sırasında gerçek müşteri verisi yerine sentetik/anonim veri kullanmak iyi bir alışkanlıktır.
  • Türkçe karakterler bozuk görünürse? Genelde iki sebep olur: dosya encoding'i veya Blogger'a yapıştırma modu. Bu dosya UTF-8 olarak hazırlanmıştır. Blogger'da HTML modunda yapıştırmak çoğu zaman sorunu çözer.

Mini Çalışma: Kendi Deneme Setini Oluştur

Bu yazıyı gerçekten değerli kılmak için sana küçük bir "ödev" seti bırakmak istiyorum. Eğer bir modeli seçmek istiyorsan, şu üç tip prompt hazırla:

  • Format testi: "5 maddeyle anlat, her madde 1 cümle olsun" gibi.
  • Akıl yürütme testi: "Adım adım açıkla" gibi.
  • Senaryo testi: "Benim işim şu, bana bir taslak çıkar" gibi.

Sonra aynı üç promptu üç farklı modelde dene. Karşılaştırma yaparken sadece "doğru mu?" diye bakma; rubriğe geri dön: Talimat takibi, tutarlılık, okunabilirlik ve hız. Bu küçük alışkanlık, öğrenme sürecini hızlandırır ve model seçimini daha sağlam yapar.

Benim Önerdiğim Deneme Stratejisi

Eğer bir proje için model seçeceksem ben genelde şu akışla ilerliyorum:

  • Önce 2-3 aday model belirlerim (biri hızlı/küçük, biri büyük/kaliteli, biri kod odaklı vb.).
  • compare_models.py ile hızlı karşılaştırma yaparım.
  • Rapor dosyasından cevapları okur, talimat takibi ve tutarlılığa bakarım.
  • Seçtiğim 1-2 modeli app.py ile manuel prompt testine sokarım.
  • Sonra uygulama entegrasyonuna geçerim (Python client ile).

Bu akışın güzelliği şu: Model seçimi "hissiyat" değil, kısa ama sistematik bir deneme sürecine dayanıyor. Üstelik bunu donanım yatırımı yapmadan başlatabiliyorsun.

Videoyu ve Kodları Burada Bulabilirsin

YouTube eğitim kaydı: https://youtube.com/live/QEZ8oF4A68k

GitHub deposu (README ve örnek kodlar): https://github.com/kmkarakaya/OllamaCloud

Resmi kaynaklar:

Kapanış

Ben bu eğitimi, "donanımım yetmiyor" bahanesinin seni açık kaynak LLM denemekten uzaklaştırmaması için hazırladım. Ollama Cloud ile hem farklı modelleri hızlıca deneyebilir, hem de seçtiğin modeli Python tarafında gerçek bir uygulamaya bağlayabilirsin.

Eğer sen de açık kaynak LLM'leri hızlıca denemek, karşılaştırma yapmak ve pratik bir akış kurmak istiyorsan videoyu izle, depo içindeki örnekleri çalıştır, sonra kendi senaryona uyarlayıp geliştirmeye başla. Benzer içerikler için Murat Karakaya Akademi'yi takip etmeyi unutma.

Tuesday, June 24, 2025

Sayılarla Büyük Dil Modellerinin İmkan ve Kabiliyetleri: LLM'lerin Mimarisi, Yetenekleri ve Muhakeme Gücü


Sayılarla Büyük Dil Modellerinin İmkan ve Kabiliyetleri: LLM'lerin Mimarisi, Yetenekleri ve Muhakeme Gücü 

Merhaba sevgili Murat Karakaya Akademi takipçileri!

Bugün sizlerle son birkaç yılın en dönüştürücü teknolojisi olan Büyük Dil Modelleri (BDM veya İngilizce kısaltmasıyla LLM) üzerine derinlemesine bir yolculuğa çıkacağız. Bu teknoloji, ChatGPT'nin iki ay gibi inanılmaz bir sürede 100 milyon aktif kullanıcıya ulaşmasıyla hayatımıza girdi ve o zamandan beri hem teknoloji dünyasının hem de gündelik hayatımızın merkezine yerleşti. Peki bu modeller nasıl bu kadar akıllı hale geldi? İş ve bilim dünyasını nasıl kökünden değiştiriyorlar? Ve daha da önemlisi, bu gücü nasıl güvenli ve sorumlu bir şekilde kullanabiliriz?

Bu yazıda, elinizdeki sunumun tüm detaylarını kullanarak bu soruların yanıtlarını arayacağız. Amacımız, yöneticilerden geliştiricilere, akademisyenlerden teknoloji meraklılarına kadar tüm paydaşlara, BDM'lerin potansiyelini ve mimarisini sayılarla ve kanıtlarla ortaya koyarak pratik içgörüler sunmaktır.

Eğer bu konuyu bir de video üzerinden dinlemek isterseniz, sunumun detaylı anlatımını yaptığım YouTube videomuza da göz atmanızı şiddetle tavsiye ederim. 

Hazırsanız, Büyük Dil Modellerinin büyüleyici dünyasına dalalım!

Büyük Dil Modelleri Neden Bu Kadar Önemli? Sayılarla Panoramik Bir Bakış

Bir teknolojinin önemini anlamanın en iyi yollarından biri, yarattığı etkiyi somut verilerle görmektir. BDM'ler söz konusu olduğunda, rakamlar gerçekten de baş döndürücü. Gelin bu "yapay zeka patlamasının" ardındaki çarpıcı kanıtlara birlikte göz atalım.

Tablo 1 ve Tablo 2 olarak referans vereceğimiz veriler, dört ana eksende durumu özetliyor:


  1. İnanılmaz Yayılım Hızı: Reuters'ın bildirdiğine göre ChatGPT, aylık 100 milyon aktif kullanıcıya sadece iki ayda ulaşarak internet tarihindeki "en hızlı büyüyen uygulama" unvanını kazandı. Bu, daha önce Instagram, TikTok gibi fenomenlerin bile yıllarını alan bir başarıydı. Bu durum, BDM tabanlı uygulamaların ne kadar sezgisel ve kitleler tarafından ne kadar hızlı benimsenebilir olduğunu gösteriyor.

  2. Kurumsal Dünyada Derin Entegrasyon: Bu teknoloji sadece son kullanıcılar arasında popüler olmakla kalmadı. McKinsey & Company tarafından 2025 için yapılan küresel bir anket, şimdiden şirketlerin %75'inden fazlasının en az bir iş fonksiyonunda Üretken Yapay Zeka (Generative AI) kullandığını ortaya koyuyor. Pazarlama metinleri oluşturmaktan yazılım kodlamaya, müşteri hizmetlerinden finansal analizlere kadar sayısız alanda BDM'ler aktif olarak değer üretiyor.

  3. Devasa Pazar Büyüklüğü ve Sermaye Akışı: Rakamlar, bu alanın ekonomik potansiyelini de gözler önüne seriyor. Grand View Research'e göre, Üretken Yapay Zeka pazarının 2024'te 17.109 milyar dolarlık bir değere ulaşması ve 2030'a kadar yıllık yaklaşık %30'luk bileşik büyüme oranıyla (YBBO) büyümesi bekleniyor. Bu potansiyelin farkında olan yatırımcılar da boş durmuyor. CB Insights verilerine göre, 2024 yılında risk sermayesi (VC) fonlarının %37'si gibi dikkat çekici bir oranı doğrudan yapay zeka girişimlerine aktarıldı. Bu, inovasyonun ve yeni BDM tabanlı çözümlerin artarak devam edeceğinin en net göstergesi.

  4. Bilimsel Üretkenlikte Çığır Açan Etki: BDM'lerin en heyecan verici etkilerinden biri de bilim dünyasında yaşanıyor. arXiv'de yayınlanan ve 67.9 milyon makaleyi analiz eden bir çalışma, yapay zeka araçlarını kullanan araştırmacıların %67 daha fazla yayın yaptığını ve tam 3.16 kat daha fazla atıf aldığını bulguladı. Bu, BDM'lerin sadece mevcut bilgiyi özetlemekle kalmayıp, hipotez geliştirmeden veri analizine kadar bilimsel keşif sürecini hızlandıran bir katalizör olduğunu kanıtlıyor.

Özetle: Karşımızdaki tablo, BDM'lerin geçici bir heves olmadığını; aksine, internetin icadı veya mobil devrim gibi temel bir teknolojik dönüşüm olduğunu net bir şekilde ortaya koyuyor.


LLM'lerin Mimarisi, Yetenekleri ve Muhakeme Gücü: Nasıl Bu Kadar Akıllandılar?

Peki, bu modellerin bu kadar etkileyici yeteneklere ulaşmasının ardında ne yatıyor? Cevap, son yıllarda mimarilerinde yaşanan devrimsel sıçramalarda gizli. 

Mimari Sıçramalar ve Temel Kavramlar

Eskiden dil modelleri daha basit ve kural tabanlıyken, 2017'de tanıtılan Transformer Mimarisi her şeyi değiştirdi. Ancak asıl "akıllanma" süreci, bu temel mimari üzerine inşa edilen yenilikçi katmanlarla gerçekleşti.


Tablo 3'e baktığımızda, günümüzün en güçlü modellerinin (GPT-4.1, Llama 4 Scout, Gemini 1.5 Pro, GPT-4o) ortak bazı mimari özelliklere sahip olduğunu görüyoruz:

  • Spars Mixture-of-Experts (MoE): Bu, belki de en önemli mimari yenilik. Geleneksel bir model, bir görevi çözmek için devasa ve tek parça bir sinir ağı kullanır. MoE ise bu yaklaşımı değiştirir. Modeli, her biri belirli konularda uzmanlaşmış daha küçük "uzman" (expert) ağlara böler. Bir "yönlendirici" (router) katmanı, gelen veriyi analiz eder ve görevi en iyi çözeceğine inandığı uzman veya uzmanlara yönlendirir.

    • Nasıl Uygulanır? Bu mimari, modelleri hem eğitirken hem de çalıştırırken çok daha verimli hale getirir. Tüm devasa ağı çalıştırmak yerine sadece ilgili uzmanları aktive ederek hesaplama maliyetini düşürür. Örneğin, GPT-4.1'in yaklaşık 16 uzmana sahip olduğu belirtiliyor. Bu, modelin hem daha hızlı hem de daha yetenekli olmasını sağlar. Sunumumuzdaki Şekil 5, standart bir Transformer bloğu ile MoE bloğu arasındaki farkı görsel olarak harika bir şekilde anlatmaktadır. Şekillerde, MoE mimarisindeki "Router" katmanının gelen görevi nasıl farklı uzmanlara dağıttığını görebilirsiniz.

https://www.dailydoseofds.com/p/transformer-vs-mixtureof-experts-in-llms/
  • Çoklu Mod (Multimodality): İlk dil modelleri sadece metin anlıyor ve üretiyordu. Tablo 3'teki modern modeller ise metin, görsel, ses ve hatta video gibi birden çok veri türünü aynı anda işleyebiliyor. Örneğin, Gemini 1.5 Pro'nun video dahil çoklu mod desteği sunması, ona bir film fragmanı izletip özetini istemenizi veya bir grafik tasarımın kodunu yazdırmanızı mümkün kılıyor.

  • Devasa Bağlam Penceresi (Context Window): Bağlam penceresi, bir modelin tek seferde ne kadar bilgiyi hafızasında tutabildiğini belirtir. İlk modeller birkaç sayfalık metni zor hatırlarken, Meta'nın Llama 4 Scout modelinin 10 milyon token'lık bağlam penceresi, neredeyse bir kütüphaneyi aynı anda analiz edebilmesi anlamına gelir. Bu, modelin çok uzun belgelerdeki veya karmaşık kod tabanlarındaki bağlantıları kurabilmesi, tutarlılığı koruyabilmesi ve derinlemesine muhakeme yapabilmesi için kritik bir yetenektir.

Muhakemenin Sınırları: En Yeni "Reasoning" Modelleri ve Ortak Başarı Formülleri

BDM'ler sadece bilgi depolamakla kalmıyor, aynı zamanda karmaşık problemler üzerinde "akıl yürütebiliyor".  Tablo 4, bu alandaki en yeni modeller olan OpenAI o3 ve DeepSeek R1 gibi sistemlerin kullandığı ortak teknikleri listeliyor.

Bu modellerin başarısının ardındaki ortak paydalar şunlardır:

  • MoE + Retrieval (Getirme): Yukarıda bahsettiğimiz MoE mimarisi, genellikle Retrieval-Augmented Generation (RAG) olarak bilinen bir teknikle birleştirilir. RAG, modelin bir soruya cevap vermeden önce kendi iç bilgisinin dışına çıkıp güncel ve güvenilir veritabanlarından veya belgelerden ilgili bilgiyi "getirmesini" (retrieve) sağlar. Böylece model, hem daha doğru ve güncel cevaplar verir hem de "halüsinasyon" olarak bilinen bilgi uydurma eğilimini azaltır.

  • Zincirleme Düşünce (Chain-of-Thought - CoT) ve Plan-and-Execute: Bu, modelin bir soruyu yanıtlarken düşünme sürecini adım adım açıklamasıdır. Model, karmaşık bir problemi daha küçük, yönetilebilir adımlara böler. "Plan-and-Execute" ise bu tekniği bir adım ileri taşır: Model önce bir çözüm planı oluşturur, sonra bu planı adım adım uygular ve her adımda kendini kontrol eder. Bu, özellikle matematik ve kodlama gibi çok adımlı mantık gerektiren görevlerde başarıyı artırır.

  • Emniyet Katmanı (Guard-Rail): Bu güçlü modellerin sorumlu bir şekilde kullanılması hayati önem taşır. "Guard-Rail" olarak adlandırılan emniyet katmanları, modelin zararlı, etik dışı veya tehlikeli içerikler üretmesini engellemek için tasarlanmış filtreler ve kontrol mekanizmalarıdır.

Pratik İpucu: Kendi projelerinizde bir BDM kullanacaksanız, sadece modelin gücüne değil, bu gelişmiş muhakeme ve güvenlik tekniklerini destekleyip desteklemediğine de bakın. Özellikle kurumsal bir çözüm geliştiriyorsanız, RAG ve Guard-Rail yetenekleri olmazsa olmazdır.


Sayılarla Büyük Dil Modellerinin Gücü: Başarım Testleri ve IQ Metaforu

Modellerin mimarisini anladık, peki performanslarını nasıl objektif olarak ölçebiliriz? Bu noktada devreye benchmark yani başarım testleri giriyor.

MMLU Benchmark'ı Nedir?

Sunumumuzun 13. sayfası, sektördeki en saygın testlerden biri olan MMLU (Massive Multitask Language Understanding) hakkında bize detaylı bilgi veriyor.

  • Tanım: 2021'de OpenAI tarafından tanıtılan MMLU, dil modellerinin genel bilgi ve akıl yürütme becerilerini ölçen kapsamlı bir testtir.
  • Kapsam: STEM (bilim, teknoloji, mühendislik, matematik), sosyal bilimler, beşeri bilimler ve hukuk gibi profesyonel konular dahil olmak üzere toplam 57 farklı alanı kapsar. Sorular, ortaokul seviyesinden lisansüstü uzmanlık seviyesine kadar geniş bir yelpazede yer alır.
  • Amaç: Modelin sadece ezberlenmiş bilgiyi değil, farklı disiplinlerdeki bilgisini kullanarak muhakeme yapma ve problem çözme yeteneğini test etmektir.
  • İnsn Performansı: Bu testte, alanında uzman bir insanın ortalama başarımının yaklaşık %89 olduğu kabul edilir. Bu, modellerin performansını karşılaştırmak için bize önemli bir referans noktası sunar.

Muhakeme Gücünün Karşılaştırması

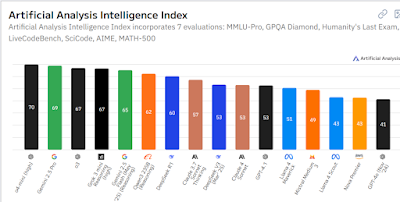
Şekil 6 Artificial Analysis Intelligence Index grafiği, güncel modellerin bu zorlu testlerdeki performansını gözler önüne seriyor. Grafikte, GPQA Diamond ve AIME gibi insanüstü düzeyde zor kabul edilen yarışma sorularını içeren testlerde, OpenAI'nin o3 ve xAI'nin Grok 3 gibi modellerinin skorlarının, uzman-insan bandının üst sınırına dayandığını veya geçtiğini görüyoruz. Bu, yapay zekanın en karmaşık entelektüel görevlerde bile insanlarla rekabet edebilir hale geldiğinin bir kanıtıdır.


Bir IQ Metaforu: Yapay Zeka Ne Kadar "Zeki"?

Modellerin bu başarım skorlarını daha anlaşılır kılmak için ilginç bir metafor kullanılıyor: IQ testi.  Lifearchitect web sitesinde sunulan analiz, bu konuda çarpıcı bir perspektif sunuyor. Bu analize göre, ortalama bir insanın MMLU'daki %34'lük performansı kabaca 100 IQ puanına denk kabul ediliyor. Bu doğrusal ölçeklendirme kullanıldığında, günümüzün en iyi modellerinin "tahmini" IQ skorları dudak uçuklatıyor:

  • GPT-4.1 → IQ ≈ 260
  • Gemini 2.5 Pro → IQ ≈ 248
  • Grok 3 β → IQ ≈ 235

Önemli Not: Elbette bu bir metafordur. BDM'ler insanlar gibi bilinçli veya duygusal bir zekaya sahip değildir. Bu "IQ" skoru, sadece belirli bilişsel görevlerdeki problem çözme yeteneklerini, insanlarla kıyaslanabilir bir ölçeğe oturtma denemesidir. Yine de bu karşılaştırma, modellerin ulaştığı yetkinlik seviyesini anlamak için güçlü bir araçtır. Sunumun 16. sayfasındaki Şekil 7'de yer alan ve farklı modelleri bir IQ dağılım eğrisi üzerinde gösteren grafik, bu durumu görsel olarak özetlemektedir.


Sonuç, Öneriler ve Geleceğe Bakış

Bu derinlemesine yolculuğun sonuna gelirken, vardığımız sonuçlar oldukça net. Sunumun kapanış sayfasında da vurgulandığı gibi: "LLM’ler iş değeri yaratmada çarpıcı bir kaldıraç sağlıyor; ancak eşzamanlı risk eğrisi de hızla tırmanıyor."

Bu, bir yanda verimlilikte, inovasyonda ve bilimsel keşifte eşi benzeri görülmemiş fırsatlar sunan, diğer yanda ise yanlış bilgi, güvenlik açıkları ve etik sorunlar gibi ciddi riskler barındıran çift taraflı bir kılıçtır.

Peki ne yapmalıyız?

  • Yöneticiler ve Liderler İçin: BDM'leri bir "sihirli değnek" olarak görmekten ziyade, stratejik bir araç olarak ele alın. Kurumunuzdaki en büyük verimsizliklerin veya en değerli fırsatların nerede olduğunu belirleyin ve BDM'leri bu noktalara odaklanarak küçük, kontrol edilebilir pilot projelerle test edin.
  • Geliştiriciler ve Mühendisler İçin: Sadece API kullanmanın ötesine geçin. MoE, RAG, CoT gibi temel mimarileri ve teknikleri anlamaya çalışın. Bu, size sadece daha iyi uygulamalar geliştirme değil, aynı zamanda modellerin sınırlarını ve potansiyel zayıflıklarını anlama yeteneği de kazandıracaktır. Güvenlik (Guard-Rails) ve sorumlu yapay zeka prensiplerini projelerinizin en başına koyun.
  • Tüm Teknoloji Meraklıları İçin: Bu alandaki gelişmeleri takip etmeye devam edin. Öğrenin, deneyin ve sorgulayın. Bu teknoloji, önümüzdeki on yılda hayatımızın her alanını şekillendirecek ve bu dönüşümün bir parçası olmak, hem kişisel hem de profesyonel gelişiminiz için kritik öneme sahip olacak.

Bu heyecan verici ve bir o kadar da karmaşık konu hakkındaki düşüncelerinizi merak ediyorum. Siz ne düşünüyorsunuz? BDM'lerin gelecekte hayatımızı en çok hangi alanlarda etkileyeceğini öngörüyorsunuz? Yorumlarda bizimle paylaşın!

Bu detaylı analizi faydalı bulduysanız ve yapay zeka, veri bilimi gibi konularda daha fazla derinlemesine içerik görmek istiyorsanız, Murat Karakaya Akademi YouTube kanalına abone olmayı unutmayın! Desteğiniz, daha fazla kaliteli içerik üretmemiz için bize ilham veriyor.

Saturday, May 17, 2025

Açık Kaynak Büyük Dil Modellerinin Stratejik Gücü: Yerel Olarak Model Çalıştıran Askeri ve Sivil Kurumlar İçin Yetenekler, Kullanım Alanları ve Gelecek Perspektifi

Açık Kaynak LLM’lerin Stratejik Gücü: Yerel Model Kullanımıyla Askeri ve Sivil Kurumlar İçin Yetenekler, Kullanım Alanları ve Gelecek Perspektifi

🧭 Neden Açık Kaynak?

Açık kaynak büyük dil modelleri (LLM’ler), mimarileri ve ağırlıkları kamuya açık olan yapay zeka sistemleridir. Bu sayede geliştirme, ince ayar (fine-tuning) ve dağıtım işlemleri serbestçe yapılabilir. Açık kaynak yazılım hareketinden ilham alarak ortaya çıkan bu modeller, ortak bilgi birikimi, şeffaflık ve iş birliğine dayalı inovasyonun avantajlarını taşımaktadır.

Yazılım geliştirme ilk başladığında, geliştiriciler çalışmalarından para kazanmak istiyordu. Zamanla kapalı kaynak sistemler ortaya çıktı ama bu sistemler bazı riskleri de beraberinde getirdi. Örneğin, kapalı kaynaklı yazılımlarda arka kapılar veya güvenlik açıkları kamu denetimi olmadan istismar edilebilir. Açık kaynak yazılımlar –ve artık açık LLM’ler– bu riski ortadan kaldırır. Herkes kodu inceleyebilir, hataları tespit edebilir ve düzeltmelere katkı sağlayabilir. Böylece daha sağlıklı ve güvenli bir ekosistem oluşur.

LLM’ler de bu durumdan farklı değil. DeepSeek, Meta veya Google Gemma gibi açık modeller sayesinde araştırmacılar mimari ve eğitim tekniklerini öğrenebilir. Bu kolektif ilerleme herkesin yararınadır. Örneğin, DeepSeek’in akıl yürütmeyi geliştirmeye yönelik pekiştirmeli öğrenme yaklaşımı açık kaynak topluluğunda hızla benimsendi.

Murat Karakaya Akademi’de sıkça gelen bir soru:
🗣️ “Açık kaynak LLM’ler, veri gizliliği ve yerel AI kullanımı öncelikli alanlarda –örneğin milli savunma veya kamu kurumlarında– pratik olarak kullanılabilir mi?”

Bu yazıda açık kaynak LLM’lerin tam potansiyeli, askeri ve sivil sektörlerdeki uygulamaları ve çeşitli kullanım senaryoları için donanım ihtiyaçları ele alınmaktadır.

Eğer isterseniz bu içeriği Murat Karaka Akademi Youtube knalımdan seyredebilirsiniz:


✅ Veri Gizliliğine Duyarlı Kurumlar İçin Açık Kaynak LLM’lerin Avantajları

💰 Maliyet Etkinliği ve Erişilebilirlik

Açık kaynak LLM’ler genellikle ücretsiz veya düşük maliyetlidir. Bu sayede sivil ve askeri kurumlar, büyük bütçelere ihtiyaç duymadan yapay zeka kapasitesi oluşturabilir. Bu modeller kurum içi sistemlere indirilebilir ve internete bağlı olmadan (ör. intranet üzerinden) çalıştırılabilir.

OpenAI ya da Gemini gibi dış servis sağlayıcılarına erişimi olmayan ya da veri gizliliği nedeniyle güvenmeyen kurumlar bu modelleri yerel olarak kullanabilir. Örneğin, Türk Silahlı Kuvvetleri, milli güvenlik ajansları veya savunma sanayii firmaları bu modelleri yerel altyapılarında güvenli şekilde dağıtabilir.

🔍 Özelleştirilebilirlik ve Şeffaflık

Kapalı sistemlerde model mimarisi veya eğitim süreci hakkında bilgi edinmek mümkün değildir. Açık kaynak modeller ise tam belgeleri, eğitim veri referansları ve uygulama ayrıntıları ile birlikte gelir. Kurumlar, bu modelleri kendi özel veri kümeleriyle eğitebilir –verileri üçüncü taraf bulutlara yüklemeye gerek kalmadan.

Linux dağıtımlarında olduğu gibi, LLM’ler de belirli alanlara özel şekilde özelleştirilebilir:

  • Hukuk danışmanlığı (ör. hukuk büroları)

  • Otomotiv güvenliği (ör. TOGG)

  • Enerji altyapısı takibi (ör. internet bağlantısı olmadan)

🛡️ Yerel Dağıtım ve Veri Güvenliği

LLM’lerin yerel olarak çalıştırılması, gizli veya hassas verilerin tam kontrolünü sağlar. Ulusal savunma, istihbarat veya kolluk kuvvetleri gibi alanlarda internete çıkış sadece tercih değil, zorunluluktur. Açık modeller, ağırlıkların indirilmesinden çıkarım (inference) ayarlarına kadar tam yığın dağıtım imkânı sunar.

NATO gibi global kurumlar bile internetsiz (air-gapped) sistemler kullanmaktadır. Açık LLM’ler, bu tür ortamlara en güncel yapay zekayı güvenle entegre etme fırsatı sunar.

🌐 Topluluk Tabanlı İnovasyon

Dünyanın dört bir yanındaki geliştiriciler Hugging Face ve GitHub gibi platformlarda açık modelleri geliştirmeye katkı sağlıyor. Hata düzeltmelerinden eklenti geliştirmeye kadar, ekosistem canlı ve üretken. Örneğin Open WebUI, LM Studio veya Ollama gibi topluluk tarafından geliştirilen arayüzler yerel modellerle kullanıcı dostu etkileşim sunar.

🔗 Tedarik Zinciri Bağımsızlığı

Kapalı kaynak API’lere güvenmek, fiyatlandırma, lisans ve hizmet devamlılığı gibi dış etkenlere bağımlılığı artırır. Sağlayıcı değiştirmek zaman ve maliyet ister. Açık modeller bu bağımlılığı ortadan kaldırır ve uzun vadeli sürdürülebilirlik sunar.

🚀 Hızlı Uyarlama

Açık kaynak LLM’lerdeki araştırmalar ve gelişmeler topluluk içinde hızla yayılır. DeepSeek’in çoklu tekniklerle yaptığı ince ayar çalışmaları, LLaMA 3 ve Qwen gibi yeni modelleri etkilemiştir. Yayınlanan makaleler ve paylaşılan kodlar sayesinde, yüksek lisans öğrencileri bile ileri seviye AI tekniklerini deneyebilir.

🛠️ Alan Odaklı İnce Ayar (Fine-Tuning)

Açık LLM’ler savunma veya kamuya yönelik özel alanlarda şu şekilde uyarlanabilir:

  • Stratejik metin analizi

  • İstihbarat raporu özetleme

  • Hukuki veya idari belge işleme

  • Kurum içi sistemler için doğal dil arayüzleri

Bu ince ayar işlemleri tamamen kurum içi sistemlerde gerçekleştirilebilir. Belgeleri dışa yüklemeye gerek yoktur. Hukuk ofisleri, askeri birimler veya AR-GE departmanları, modelleri kendi iş akışlarına göre özelleştirebilir.

🎓 Eğitim ve Simülasyon

Askeri eğitim simülasyonlarında ve kamu hizmeti eğitimlerinde, durumsal farkındalık ve dil becerileri kazandırmak için kullanılabilir.

🌍 Çok Dilli Yetenekler

Farklı dilleri desteklemeleri sayesinde çok kültürlü topluluklara hizmet etmek ve uluslararası iş birliklerine katkı sağlamak mümkündür. Qwen, Gemma ve DeepSeek gibi modeller artık Türkçe dahil 120’den fazla dili desteklemektedir.


⚖️ Açık vs Kapalı Modeller

ArtificialAnalysis.ai sitesinde yayımlanan karşılaştırmaya göre:

  • Açık modellerin performansı, kapalı modellere yaklaşmaktadır.

  • Özelleştirme ve güvenli dağıtımda açık modeller öne çıkmaktadır.

  • Veri kontrolü ve entegrasyon esnekliği isteyen kurumlar için idealdir.


🔍 Örnek Kullanım: Açık Kaynak ile İstihbarat ve Belge Analizi

Görev: “Yunanistan'ın hangi ülkelerden askeri teçhizat aldığını, ürün ve maliyet detaylarıyla listele.”

Açık kaynaklı bir model, belge ve görsel analiz araçlarıyla entegre şekilde:

  • Alım verilerini çıkarabilir

  • Bilgiyi özetleyebilir

  • Eğilim ve içgörü oluşturabilir

Aynı yöntem, hukuk uyumu izleme veya bütçe analizi gibi sivil alanlarda da geçerlidir.


🖼️ Görsel ve İmge Tabanlı Zeka

LLM’lerin görüntü tanıma ile birleşmesi sayesinde:

  • Uydu görüntüsü analizi

  • Altyapı takibi

  • Ekipman sınıflandırması yapılabilir.

Bu kullanım alanları hem askeri keşif hem de şehir planlama veya afet yönetimi gibi sivil alanlara hizmet eder.


🔐 Riskler ve Güvenlik Önlemleri

⚠️ Halüsinasyon ve Bilgi Kirliliği

Yanlış veya uydurma çıktılar üretebilir.
🛡️ Çözüm: Zeminleme (grounding) ve doğrulama katmanları eklenmeli.

⚠️ Kötüye Kullanım ve Siber Güvenlik

Gereken önlemler alınmazsa kötüye kullanılabilir.
🛡️ Çözüm: İzole çalışma ortamları ve sıkı erişim politikaları uygulanmalı.


📊 Model Büyüklüğüne Göre Donanım Gereksinimleri

Model BüyüklüğüGerekli VRAMTipik GPU’larNotlar
1.5B4–6 GBGiriş seviyesiFP16/BF16 ile çalışır
7B/8B8–12 GBRTX 3080+Kuantizasyon VRAM’i azaltır
13B/14B12–16 GBÜst düzey GPU
32B16–24 GBRTX 4090, A6000
70B32–48 GBÇoklu GPU veya profesyonel sistemler

👉 Kullanım Önerisi:

  • 7B altındaki modeller, 8–12 GB VRAM’li GPU’larda bireysel geliştiriciler tarafından kullanılabilir.

  • 13B/14B modeller, orta düzey yerel kurumlar için RTX 4090 ile uygundur.

  • Sürekli iş yükü veya hassas görevler için 32B+ modeller önerilir.


🖥️ GPU Fiyat ve Kapasite (USD Tahmini)

GPU ModeliFiyatVRAMDesteklenen ModellerNotlar
RTX 3080$480–70010GBLLaMA 2 7B, Mistral 7BUygun maliyetli
RTX 4090$1,300–1,80024GBLLaMA 2 70B (quantized)Yaygın ve güçlü
A6000$3,000–4,00048GBClaude 3 Opus (quant.), LLaMA 3Kurumsal seviye
H100$16,500–26,00080GBGPT-4, Claude 3 OpusVeri merkezi için

👉 Kullanım Önerisi:

  • Pilot çalışmalar için RTX 3080/3090 yeterli olabilir.

  • Gerçek zamanlı performans isteyen kamu kurumları RTX 4090 veya A6000 tercih etmeli.

  • Yüksek kapasiteli kamu sistemleri için H100 idealdir.


📈 Kullanıcı Sayısına Göre GPU İhtiyacı

KullanıcıGPU SayısıToken Üretim HızıNot
1–51 H1002–5 token/snKişisel/küçük ekip
20–254 H10010–15 token/snOrta ölçekli kurum
75–10016–20 H10025–30 token/snBüyük kurum
300–40064–80 H10070–100 token/snUlusal düzey kullanım


Verimlilik Artırıcı Faktörler:

  • Kuantizasyon eşzamanlı kullanıcı sayısını artırır.

  • Uzun bağlam pencereleri ek hafıza gerektirir.

  • Toplu (batch) ve spekülatif çıkarım, verimliliği büyük ölçüde artırır.


🧭 Kurumlar İçin Aşamalı Geçiş Yol Haritası

1️⃣ İhtiyaç Analizi ve Hedef Belirleme (1-2 ay)
2️⃣ Minimum Altyapı (2-3 ay) – 2–4 GPU ile 20–30 kullanıcı testi
3️⃣ Operasyonel İyileştirme (3-4 ay) – Kuantizasyon ve kullanıcı geri bildirimi
4️⃣ Kontrollü Ölçekleme (4-6 ay) – 70B+ model testi ve kullanıcı sayısını artırma
5️⃣ Tam Dağıtım (6+ ay) – MLOps otomasyonu ve tüm birimlere genişletme

Yararları:

  • Maliyet-etkin ölçeklenme

  • Kurumsal bilgi transferi

  • Kullanıcı ihtiyaçlarına sürekli uyum

  • Yüksek benimseme oranı ve direnç


🌟 Gelecek Vizyonu ve Sonuç

Açık kaynak LLM’ler, robotik, siber güvenlik ve alan bazlı iş akışlarıyla entegre edildiğinde:

  • Daha akıllı otonom sistemler

  • Sivil teknoloji egemenliği

  • Yerel yapay zeka ile daha düşük risk sağlar.

🎯 Eylem Çağrısı: Tüm kamu ve özel kurumlar açık kaynak LLM’leri incelemeye, pilotlar oluşturmaya ve ortak geliştirme süreçlerine katılmaya davetlidir.

📺 YouTube Kanalı: Murat Karakaya Akademi